
Por: Gino Marín
Publicado el: 21 de setiembre de 2026
Colaboración Académica para la Universidad CENFOTEC
Casi todas las decisiones que toma el software caben en un sí o un no.
¿Este correo es una estafa? ¿Este cliente está molesto? ¿Esta consulta va para facturación o para soporte técnico?
En los últimos años se volvió costumbre hacerle esas preguntas a un chatbot, esperar a que redacte su respuesta y después rescatar el dato útil de en medio del texto. Funciona, pero es lento, caro y frágil.
El 15 de septiembre de 2026, la empresa estadounidense TypeSafe AI presentó una alternativa que se salta ese rodeo. Se llama Jev, y su rasgo más llamativo es una ausencia: no sabe escribir.
Un modelo que responde con decisiones en lugar de párrafos
Jev recibe información, como el texto de un correo o los datos de un pedido, junto con una lista de preguntas cuyas respuestas posibles vos definiste de antemano. Puede elegir una opción de una lista, ubicar algo en una escala o calcular qué tan probable es que una afirmación sea cierta.
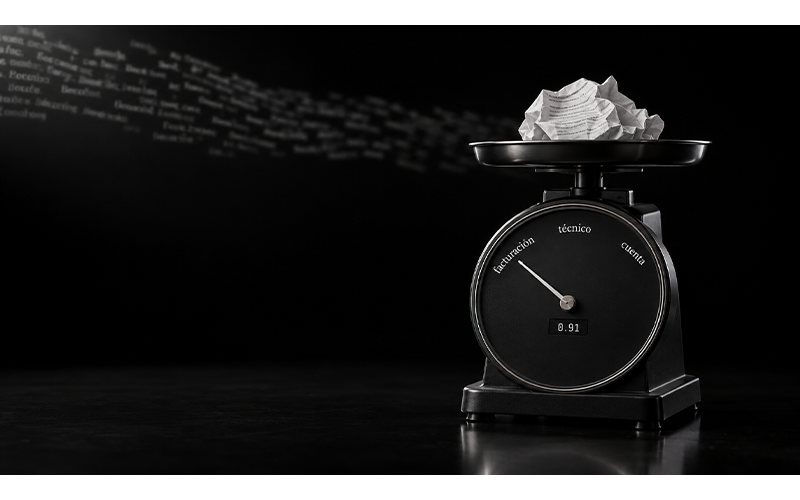
Pensalo como una balanza. Un chatbot te describe el paquete con palabras, mientras que Jev lo pone en el plato y la aguja marca un valor sobre una escala que vos grabaste antes de pesar. La aguja nunca puede señalar algo que no esté en esa escala.
La otra diferencia está en el ritmo: un chatbot escribe una palabra, después la siguiente, y cada una depende de la anterior, así que una respuesta larga siempre tarda más. Jev contesta todas las preguntas al mismo tiempo, en una sola pasada, y la empresa reporta tiempos de entre 70 y 500 milisegundos.
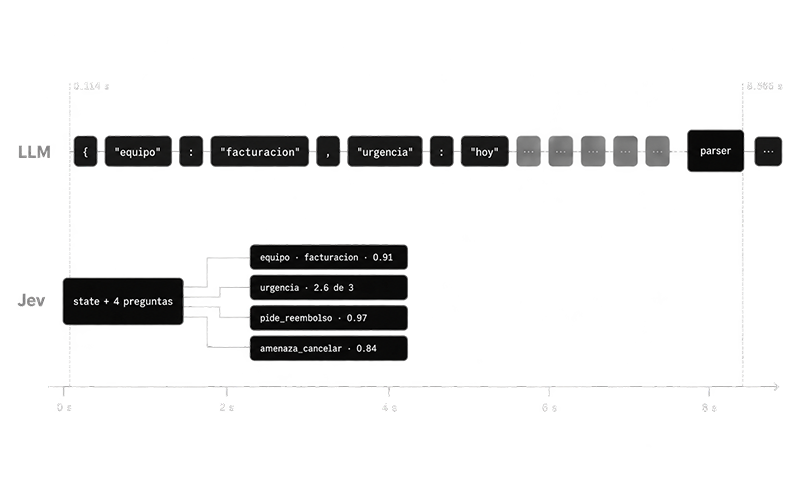
Un chatbot construye su respuesta paso a paso. Jev entrega todas sus decisiones de una vez.
El costo acompaña a la velocidad. TypeSafe cobra 0.042 dólares por cada millón de “tokens”, que son los fragmentos en que un modelo divide el texto que recibe, y no cobra nada por lo que responde.
Quién está detrás y por qué fue en contra de la corriente
Detrás del modelo está Diogo Almeida, uno de los autores principales de InstructGPT, la investigación de OpenAI que en 2022 enseñó a los modelos de lenguaje a seguir instrucciones y que terminó siendo la base de ChatGPT. Almeida fundó TypeSafe en 2024, en San Francisco, junto a Erik Gafni y Sasha Sheng, y trabajaron dos años en silencio antes de mostrar el resultado.
Su argumento tiene algo de autocrítica: los chatbots se entrenan para dar las respuestas que a las personas les gusta leer, y eso puede premiar un tono seguro aunque el contenido sea falso.
Para conversar funciona. Para que un programa decida solo, a las tres de la mañana, no tanto.
La sospecha tiene respaldo, porque el reporte técnico de GPT-4, publicado por OpenAI en 2023, mostró que antes de ese entrenamiento el modelo medía bien su propia seguridad, y que después lo hacía peor.
Por eso TypeSafe entrenó a Jev con un método propio que premia la calibración, es decir, que sus probabilidades digan la verdad. La idea se enuncia fácil: si el modelo dice 80% en mil respuestas, cerca de ochocientas deberían ser correctas. Con ese número, el software puede actuar solo cuando el modelo está seguro y pasarle a una persona los casos dudosos.
Almeida lo resumió al presentar la empresa: “las personas no pueden ser las únicas consumidoras de inteligencia”. Su apuesta es que la mayor parte de la inteligencia artificial va a trabajar dentro de los programas, en silencio, sin que nadie converse con ella.
Los nombres también cuentan la historia. La categoría “System One” viene del psicólogo Daniel Kahneman, premio Nobel de Economía, que distinguió entre un pensamiento rápido e intuitivo y otro lento y deliberado. Jev homenajea a William Stanley Jevons, el economista del siglo XIX que notó que usar el carbón con más eficiencia terminaba haciendo que se consumiera más.
Para qué sirve, qué gana un sistema y dónde se queda corto
Jev está pensado para decisiones pequeñas que se repiten millones de veces. Separar correos legítimos de intentos de estafa, enviar cada consulta al equipo correcto, revisar si la respuesta de un chatbot cita bien sus fuentes o frenar un mensaje diseñado para manipular a otro sistema de inteligencia artificial son ejemplos que la empresa documenta.
También sirve donde cada milisegundo cuenta: en una de sus demostraciones, TypeSafe lo puso a jugar Doom, el clásico videojuego de disparos, tomando unas diez decisiones por segundo, aunque el juego le llegaba descrito como texto y no como imagen.
Las ventajas frente a un chatbot son concretas: responde mucho más rápido, cuesta una fracción y sus respuestas siempre llegan en el formato esperado, así que el programa que lo usa no se cae porque el modelo decidió contestar con un párrafo. Además, cada decisión trae su probabilidad, y eso le permite al sistema saber cuándo conviene pedir ayuda.
Pero hay un problema. El mismo diseño que lo vuelve rápido le pone límites claros: Jev no escribe correos, no resume documentos, no programa y tampoco explica por qué decidió lo que decidió, algo que pesa cuando una decisión tiene que auditarse.
La propia empresa publicó una lista de sus debilidades, en la que reconoce que lee las instrucciones al pie de la letra, no es bueno contando ni comparando fechas, se confunde cuando recibe información de más y puede ser engañado por textos escritos para manipularlo.
El idioma también importa, porque TypeSafe advierte que el inglés es su idioma principal y que otros funcionan, pero no igual de bien, un detalle nada menor si trabajás en español. Además, por ahora solo se usa como servicio en la nube, con lista de espera, y nadie puede descargarlo para correrlo en sus propias computadoras.
Lo que dice la comunidad después de ponerlo a prueba
La reacción fue enorme: la discusión del lanzamiento en Hacker News, uno de los foros más influyentes entre programadores, superó los 500 comentarios, y Vercel reportó que cerca del 13% de los equipos que pagan por su servicio de modelos lo usaron en las primeras 24 horas, un récord para esa plataforma.
El entusiasmo vino con preguntas, y varios programadores cuestionaron la promesa de que Jev no alucina: es cierto que nunca responde algo fuera de las opciones permitidas, pero puede elegir la opción equivocada. El propio Almeida lo reconoció en el foro al admitir que un modelo así también puede equivocarse con total seguridad.
Las primeras pruebas independientes dejan un retrato con matices: en un experimento con 2000 correos, Jev acertó el 62.6% de las veces cuando se le preguntó directamente si un mensaje era una estafa, contra el 81.3% de Claude Haiku 4.5, un modelo conversacional de Anthropic.
Pero el mismo experimento mostró el otro lado. Cuando el autor dividió la pregunta en cinco señales simples, entre ellas si el enlace llevaba a un sitio de alojamiento gratuito, y combinó esas respuestas con una fórmula ajustada a los datos, la exactitud subió a 95.1%.
Otro estudio probó la calibración con tickets de soporte inventados, en los que la prioridad dependía de una regla interna que no aparecía en el texto. Ningún modelo podía deducirla, y aun así Jev respondió con 74% de seguridad promedio mientras acertaba menos de la mitad de las veces. El modelo no sabía que no sabía.
Mike Taylor, jefe de evaluaciones en la publicación tecnológica Every, lo describió como una regla de decisión inteligente para automatizar procesos, aunque dejó claro que qué tan bien hace su trabajo todavía está por verse.
Laya y las alternativas abiertas que aparecieron en pocos días
A los pocos días apareció Laya, una respuesta de código abierto. Su creador, Nandakishor Mukkunnoth, fundador y director ejecutivo de ConvAI Innovations, asegura que trabaja en esta misma idea desde marzo de 2025 y criticó que TypeSafe la presentara como un descubrimiento sin publicar un artículo científico, los pesos del modelo ni sus datos de entrenamiento.
Laya usa las mismas tres formas de responder: elegir, puntuar y decir sí o no. La diferencia es que cualquiera puede descargarlo gratis y ejecutarlo en sus propios equipos, sin enviar datos a otra empresa. Responde en unos 33 milisegundos con una sola tarjeta gráfica y tiene una versión preparada para más de cien idiomas.
Sus números, sin embargo, piden lectura atenta: Laya asegura superar a Jev, pero su propia documentación aclara que ese resultado se logró entrenándolo con ejemplos de la misma colección de datos con la que después lo evaluaron, y que sin ese entrenamiento rinde cerca del azar. Cuando las opciones pasan de veinte, además, Jev le gana con claridad.
Su análisis también deja una advertencia que vale para los dos: la versión en inglés de Laya no acertó ni una de cien preguntas escritas en jemer, el idioma de Camboya, y aun así reportó en promedio 95% de seguridad.
La disputa sobre quién llegó primero tampoco es sencilla, porque los trabajos que cita Mukkunnoth resuelven problemas más específicos, como estimar si una conversación de ventas terminará en compra, y la idea de clasificar texto sin entrenamiento previo tiene antecedentes académicos al menos desde 2019. Mientras tanto, la comunidad ya publica réplicas abiertas, y la propia TypeSafe liberó una herramienta para que los chatbots tradicionales respondan en su mismo formato.
Kahneman dedicó buena parte de su obra a mostrar que el pensamiento rápido acierta muchísimo y que, cuando falla, suele fallar con demasiada confianza. Jev heredó el nombre. Todavía no sabemos cuánto heredó del carácter.
—
Referencias
1. Almeida, Diogo, fundador de TypeSafe AI. “Introducing System One Models & Jev”. TypeSafe AI Blog, 15 de septiembre de 2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev
2. TypeSafe AI. Documentación, “System One”. https://docs.typesafe.ai/concepts/system-one
3. TypeSafe AI. Documentación, “AI primer”. https://docs.typesafe.ai/introduction/machine-learning-primer
4. TypeSafe AI. Documentación, “Models”. https://docs.typesafe.ai/models
5. TypeSafe AI. Documentación, “Jev 1.13 jaggedness”, revisada el 17 de septiembre de 2026. https://docs.typesafe.ai/model-jaggedness/jev-1.13
6. Business Wire. “TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI”, 15 de septiembre de 2026. https://finance.yahoo.com/technology/ai/articles/typesafe-ai-emerges-stealth-40m-190000776.html
7. Ouyang, Long; Wu, Jeff; Jiang, Xu; Almeida, Diogo y otros, OpenAI. “Training language models to follow instructions with human feedback”. NeurIPS 2022. https://arxiv.org/abs/2203.02155
8. OpenAI. “GPT-4 Technical Report”, 2023. https://arxiv.org/abs/2303.08774
9. Kahneman, Daniel. Thinking, Fast and Slow, 2011. https://www.penguinrandomhouse.com/books/89308/thinking-fast-and-slow-by-daniel-kahneman/
10. Vercel. “Jev is the fastest-adopted model in AI Gateway history”, 18 de septiembre de 2026. https://vercel.com/blog/ai-gateway-jev-model-launch
11. Hacker News. Hilo “Introducing System One Models and Jev”. https://news.ycombinator.com/item?id=49717558
12. jev-phishing-bench. “Jev vs LLM: a phishing decision benchmark with a calibration audit”, 17 de septiembre de 2026. https://github.com/anisselbd/jev-phishing-bench
13. jev-ood-calibration. “Does Jev know when it doesn’t know?”, 19 de septiembre de 2026. https://github.com/scienthoon/jev-ood-calibration
14. Taylor, Mike, jefe de evaluaciones en Every. “Mini-Vibe Check: TypeSafe’s Jev Judged Everything I’ve Written in 0.7 Seconds”. Every, 15 de septiembre de 2026. https://every.to/also-true-for-humans/mini-vibe-check-typesafe-s-jev-judged-everything-i-ve-written-in-0-7-seconds
15. Mukkunnoth, Nandakishor, fundador y CEO de ConvAI Innovations. Laya, página de investigación, septiembre de 2026. https://laya.convaiinnovations.com/
16. ConvAI Innovations. Modelos de Laya en Hugging Face. https://huggingface.co/convaiinnovations/laya
17. Mukkunnoth, Nandakishor. “SalesRLAgent: A Reinforcement Learning Approach for Real-Time Sales Conversion Prediction and Optimization”. arXiv:2503.23303, 2025. https://arxiv.org/abs/2503.23303
18. Yin, Wenpeng; Hay, Jamaal y Roth, Dan, Universidad de Pensilvania. “Benchmarking Zero-shot Text Classification: Datasets, Evaluation and Entailment Approach”. EMNLP-IJCNLP 2019. https://aclanthology.org/D19-1404/
19. TypeSafe AI. system-one-adapter-python. https://github.com/typesafe-ai/system-one-adapter-python
20. AbdelStark. “Awesome TypeSafe”, guía comunitaria de proyectos, réplicas y evaluaciones independientes. https://abdelstark.github.io/awesome-typesafe/

